Julia のデータフレーム の操作. R, Python との比較.
R のループが遅いので, Julia を試してみた。 とりあえず、データフレーム の処理とかをまとめてることにする。
インストール
以下で、macOS Package( .dmg )をダウンロードし、インストール(v1.0.1)。
実行すると、ターミナル画面が開き以下のようなメッセージが表示される。
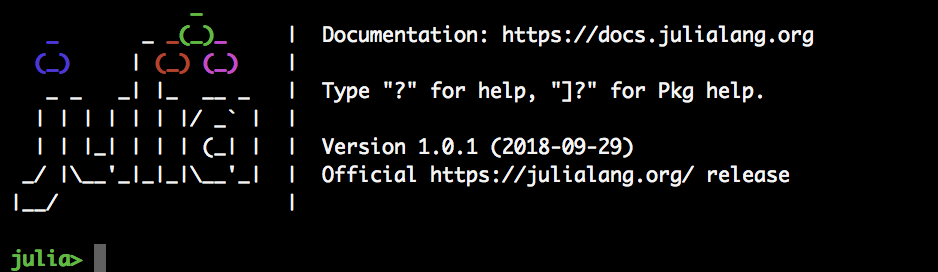
次に、jupyter notebook で使えるように IJulia をインストール。
using Pkg
Pkg.add("IJulia")
using IJulia
notebook(detached=true)
jupyter notebook を起動し、New で julia v1.0.1 が表示されている。◯
動かしてみる
データフレーム読み込み
tab 区切りの場合
using DataFrames
dataframe("")
csv の場合
deg=CSV.read("../../result/deg/A/A-E.csv")

速度比較。
大量の fastq をトリミング "Trimmomatic"
大量の fastq をトリミングしたかったので。 以下のように、fastq データがあるときに while read で2行ずつ読み込んで処理する方法。
$ find | grep fastq.gz
RUN001_1.fastq.gz
RUN001_2.fastq.gz
RUN002_1.fastq.gz
RUN002_2.fastq.gz
RUN003_1.fastq.gz
RUN003_2.fastq.gz
...
以下に示す、loop_trimming.sh, trimming.sh を用意して、
パイプして実行する。
$ find | grep fastq.gz | loop_trimming.sh
trimming.sh
#!/bin/bash

CMDNAME=`basename $0`

while getopts i:j: OPT
do
  case $OPT in
    "i" ) FLG_A="TRUE" ; INPUT1="$OPTARG";;
    "j" ) FLG_B="TRUE" ; INPUT2="$OPTARG" ;;
      * ) echo "Usage: $CMDNAME [-i INPUT1.fastq(.gz)] [-j INPUT2.fastq(.gz)] " 1>&2
          exit 1 ;;
  esac
done

trimmed1=`echo $INPUT1 | sed s/.fastq.gz/_trimmed.fastq.gz/ `
trimmed2=`echo $INPUT2 | sed s/.fastq.gz/_trimmed.fastq.gz/ `
unpared1=`echo $INPUT1 | sed s/.fastq.gz/_unpaired.fastq.gz/ `
unpared2=`echo $INPUT2 | sed s/.fastq.gz/_unpaired.fastq.gz/ `

echo $INPUT1 $trimmed1 $unpared1
echo $INPUT2 $trimmed2 $unpared2

java -jar trimmomatic-0.36.jar \
    PE \
    -threads 1 \
    $INPUT1 \
    $INPUT2 \
    $trimmed1 \
    $trimmed2 \
    $unpared1 \
    $unpared2 \
    ILLUMINACLIP:adapters.fa:2:30:10 \
    LEADING:20 \
    TRAILING:20 \
    SLIDINGWINDOW:4:15 \
    MINLEN:36
loop_trimming.sh
#!/bin/bash

while true
do
    read line1
    read line2
    if [ -z "$line1" ] ; then break ; fi

    bash trimming.sh -i $line1 -j $line2
done
参考
gtf から転写物配列取得 "gffread"
この記事では、gtf を使って、リファレンス配列から転写物の配列を切り出す方法を紹介します。
gffread は cufflinks の昨日のうちの一つで、
gtf <-> gff の変換もできます。
以下の記事を参考に実際に gffread を使って転写物の配列を切り出します。
gffread を使った transcripts fasta 転写物の配列取得 – バイオインフォ 道場 [bioinfo-Dojo]
アノテーションファイルとリファレンス配列から遺伝子領域の配列の fasta
切り出したGTFファイルとリファレンス配列から SeqKit - Ultrafast FASTA/Q kit を用いて、各遺伝子領域の配列の fasta ファイルを作成。 以下の記事を参考にさせていただきました。
続きを読む遺伝子アノテーションファイル(GTFファイル)から特定の遺伝子を抽出
GTFファイルのうち特定の(調べたい)遺伝子だけを使いたいとき、
grepコマンドを用いて、その遺伝子を含む行を抽出する方法。
orebibou.com
統計解析の学習に役立つ R データセット
R で統計解析をいろいろ試したいときに、役立つ R のデータセットがまとまっていたので
